2026年10月20日,DeepSeek(深度求索)多款标杆大模型的核心研发人员陈德里,在社交平台写下一句震撼整个AI行业的宣言:“开源与闭源,这是光明与黑暗的决战,这是人类两种命运两种前途的决战,他们要打多久就打多久,一直打到完全胜利。”
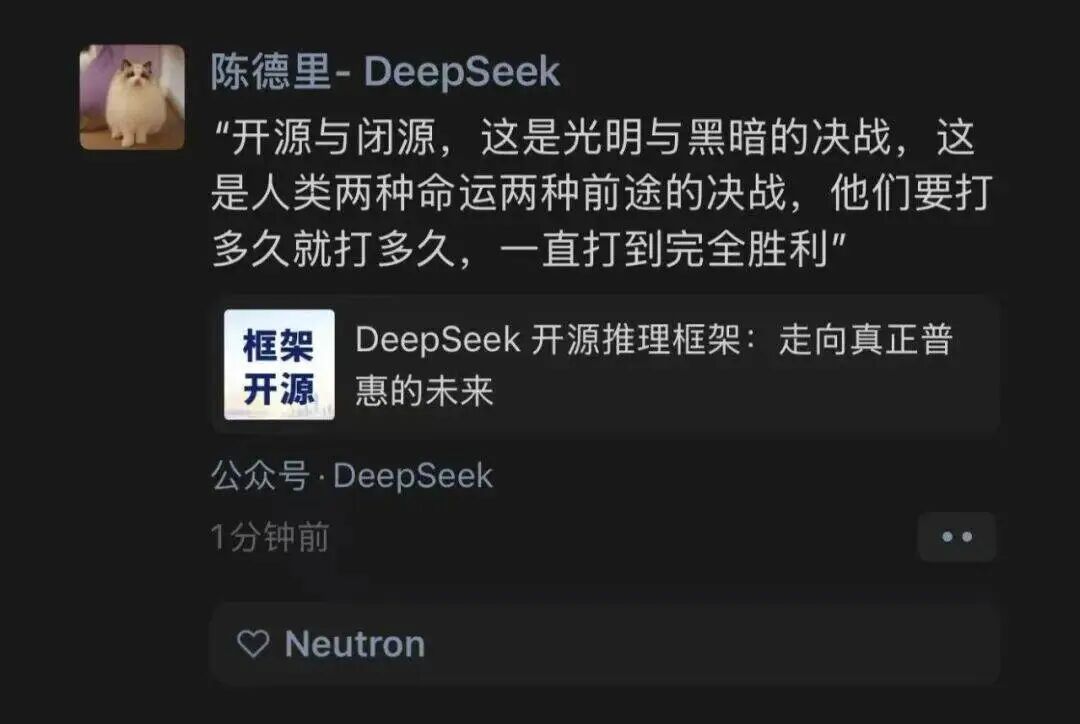
言论一经发出,迅速在海内外科技圈刷屏,引发巨大讨论。
很多人第一眼看到,会觉得措辞非常有冲击力,甚至有人会疑惑,不就是AI模型开源吗?怎么上升到 “决战” 这个高度?
在文章开始之前,我们必须要先解答一个很多人的疑惑:大家是不是觉得DeepSeek的存在感比较弱了?是不是觉得好像大家都在用豆包、千问等,似乎没有太多人用DeepSeek了吧?
对于普通人来说,DeepSeek确实没有豆包、千问等好用,确实也有很多人不用DeepSeek了,包括我。
既然大家都不怎么用DeepSeek了,那么它还有那么大的影响力吗?
有!非常有!
普通人不用DeepSeek不代表企业不用!
对于很多企业来说,它们反而不怎么用豆包、千问,它们更多用的是DeepSeek。
为什么?
我举个例子大家立刻就懂了。
比如,我以前在油田工作,如果我拿复杂工艺问题、内部数据规律、设备故障溯源、产能优化分析去问普通云端版豆包、千问,它们是很难给出有效答案的。
为什么?
因为油田油井的产量数据、压力数据、注水数据、设备运行台账、地质勘探资料、开发方案、工程方案、内部工艺报告、隐患排查记录,全部都是内部敏感数据,严禁随意向外网传输、公开外泄。
除了油田,电力、轨道交通、政务、金融风控、医院病历、制造工厂产线数据、矿山安全数据、企业核心经营台账,千千万万的核心行业,全都有大量离线、私密、不可外传的内部数据——真正决定产业效率、企业核心竞争力、国家工业根基的,恰恰是大量不会、也绝对不能上传互联网的私密数据、行业绝密资料、内部核心台账。
这就导致豆包、千问等拿不到这些资料,自然没有办法帮你分析,也就没有办法解答你提出的问题——豆包、千问、元宝这类面向普通用户的产品,属于C端通用AI。它们有一个共同局限:大众直接使用的云端版本,只能依托互联网上公开、通用、大众化的知识来回答问题。
但是,DeepSeek就不一样了。
由于DeepSeek是开源的(这个我们后面重点说),这些企业、工厂、机构、油田、涉密单位,可以直接把完整的DeepSeek模型部署在自己的内网服务器、本地机房,数据不出机房、不上外网、不外泄。
企业只需要把自己几十年积累的内部资料、行业台账、生产数据、工艺文档、内部规章全部投“喂”给本地部署的DeepSeek模型,模型会专属学习、专属训练、专属适配本行业、本企业的独有逻辑。然后企业内部员工,就可以在内网直接使用DeepSeek分析生产数据、排查设备隐患、优化产能规律、梳理内部制度、解析专属工艺、归纳历史经验、自动化处理内部工作。