现在说是80年代老旧设备更新时出的问题,好像是指向路由器。
我当然不懂FAA和L3Harris是怎么设立他们网络的。说法是L3Harris负责的FTI网络连接超过4400个FAA站点,提供约29000项电信服务,采用多家电信运营商和冗余设计。公司宣称网络可用率达到99.99971%。现在是那0.00029%出了毛病,还是从来就不是99.99971%,就要等调查了。
我只对工控网络有所了解。这是典型DCS的网络结构:
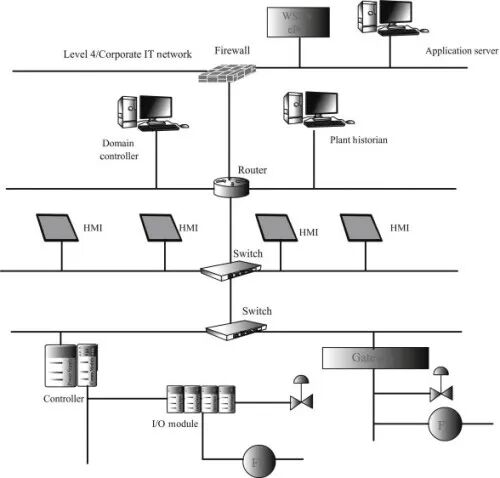
这是多层结构,每一层向上都有某种路由器、网关,有严格的通信控制协议,所有部件、线缆都有冗余,不可能因为一个坏了就系统瘫痪。万一上下层之间通信中断,下层保持独立运行,只是同层之间通过上层转发的横向联系可能也中断了。
这可能是FAA/L3Harris事件的故障模式?
新闻里只说L3Harris在升级某一匿名地点(新闻里只说undisclosed location)的网络时,造成每3-4分钟里超过千次通信请求,造成网络过载和通信严重延迟。为了避免故障扩大,只好“拉电源”式全美停飞。只说匿名地点是对的。这样关键的设施不能广而告之,否则就成了战时招引打击的重点目标了。
猜测起来,FAA的网络也是高度集中的递阶式的?这次故障的地方在很高层次的地方,所以下层网络未必瘫痪,但全国飞控高度依赖地区网络之间实时信息互换,高层一掉链子,全国就瘫痪了。
再猜测一下:这样的高层节点最起码有A/B冗余,有飞控那样的3+1表决式冗余都是可能的。这是“三决两胜”式表决式冗余,加上一个备用,在被表决“开除”的那一路出局后顶上,恢复表决功能。再有一路出问题,就再次降级到A/B冗余。这是从路由器到网线的全栈冗余。容错设计里也应该有“掉包重发”的功能,但规定连续掉包(包括不同步造成的比较失败、超时操作等)多少次后,要暂时锁死相关账户,避免无限重发造成系统瘫痪。这是70年代DCS就有的基本可靠性设计,FAA/L3Harris这次是折腾80年代的系统,不会没有这样的功能,或者更加高级的等效功能。
再猜测一下:系统更新是先A后B(表决式也需要一路一路更换),但光纤和铜线(co-ax)的速度差别太大,不同步造成掉包率超高,高频重发造成越来越多的账户被锁,一旦问题范围太大,就无法收拾了。回滚在理论上是可能性,实际上前滚需要时间,要跨过“决定性时刻”的门槛;回滚也需要时间,也有“决定性时刻”的门槛。但故障的扩大速度太快,回滚也来不及了。
在理论上,可以强行把另一路也换上光纤和新路由器,但这样的关键系统不是“拉插头、插插头”那么简单,一步一步需要很长时间。我看过DCS升级,很多时候不是性能或者功能升级,只是currency update,把已经过时、不再支持的设备换成现行生产的、功能和性能有扩大潜力但现在保持原样的设备。同步就是很关键的一步。
A/B冗余既提高可靠性,也多出来一个同步问题。平常运行中有这个问题,设备升级的时候问题更大。
金字塔网络对上层的可靠性要求特别高,这也使得上层的设备更新往往拖到最后。扁平、全联网络的可靠性更高,但故障模式大大复杂化,也不全是好事。
这次出大问题,我要是FAA/L3Harris,首先必须确认问题出在哪里。要是新旧系统不同步造成A/B失去同步,一个办法是避免短痛,留给长痛,已经升级的一半降级回到原状,先恢复工作再说,风险是以后还可能“吃二遍苦受二茬罪”。另一个办法是假定新设备没问题,冒险强推升级,另一半也趁机升级到新设备,风险是设备真有问题的话,这要退回原状就费事多了。
这四个小时里,方案A和方案B大战三百回合。谁都知道应该推动方案B,直接完成升级,但也需要L3Harris对风险作出正确评估。升级前L3Harris也是做过风险评估的,肯定还必须得到业主批准,但L3Harris最终需要对风险评估负责(批准的FAA在问责时也逃不了干系)。估计白宫、交通部、FAA都在逼问L3Harris:你能100%确保新设备没问题吗?
L3Harris估计回答:99.99971%。真走方案B的话,也是测试再测试,第二次掉链子就是直接掉人头的事了。
职业生涯里经历过这样的时刻,当然涉及的风险面没有这样大,但性质是差不多的。感同身受。