在真实空战中,飞行员需要在瞬息万变的环境中做出机动和战术决策,而我们希望让 AI 也能学会这些技能。通过强化学习,多架战斗机智能体可以自主判断何时攻击、何时撤退,并选择最优机动方式,实现“击杀最大化 + 生存最优”。
空中对抗的核心是智慧,决定胜败的往往是通过层次决策形成的精准机动,而非单纯的武力硬碰硬。
通过分层决策,高层负责战术指令(fight / escape / 选择目标),低层负责连续控制(航向、速度、武器发射)这样AI 不仅能做大局决策,还能执行精细动作。
1 项目目标
通过训练多架战斗机智能体,让它们在虚拟空战中自主做出决策。每架战机输入自身的观测信息(位置、速度、航向、敌我角度、雷达/武器状态等),输出高层动作(fight/escape/目标选择)或者低层连续控制(航向、速度、导弹发射)。通过这种方式,AI 能够同时掌握战术决策与精细机动。
2 系统架构
系统分为三大模块:
1. 环境层(仿真器):CmanoSimulator 提供时钟管理、单位管理、事件系统和地图绘制,HighLevelEnv 实现分层执行、奖励聚合和周边事件检测。
2. 模型与策略层:高层策略 CommanderGru 负责战术决策,低层控制飞行动作和武器使用。
3. 训练与评估层:使用 Ray RLlib 驱动强化学习算法(如 PPO/IMPALA/A2C),并通过 evaluation.py 评估策略效果和可视化训练结果。
3 分层强化学习设计
系统的高层负责战术级别的判断,低层则负责把战术意图转成可执行的机动动作。高层每发出一次抽象指令,低层会连续执行若干仿真子步,直到达到触发条件(距离接近、攻角变化、状态异常等)再返回高层做下一轮决策。
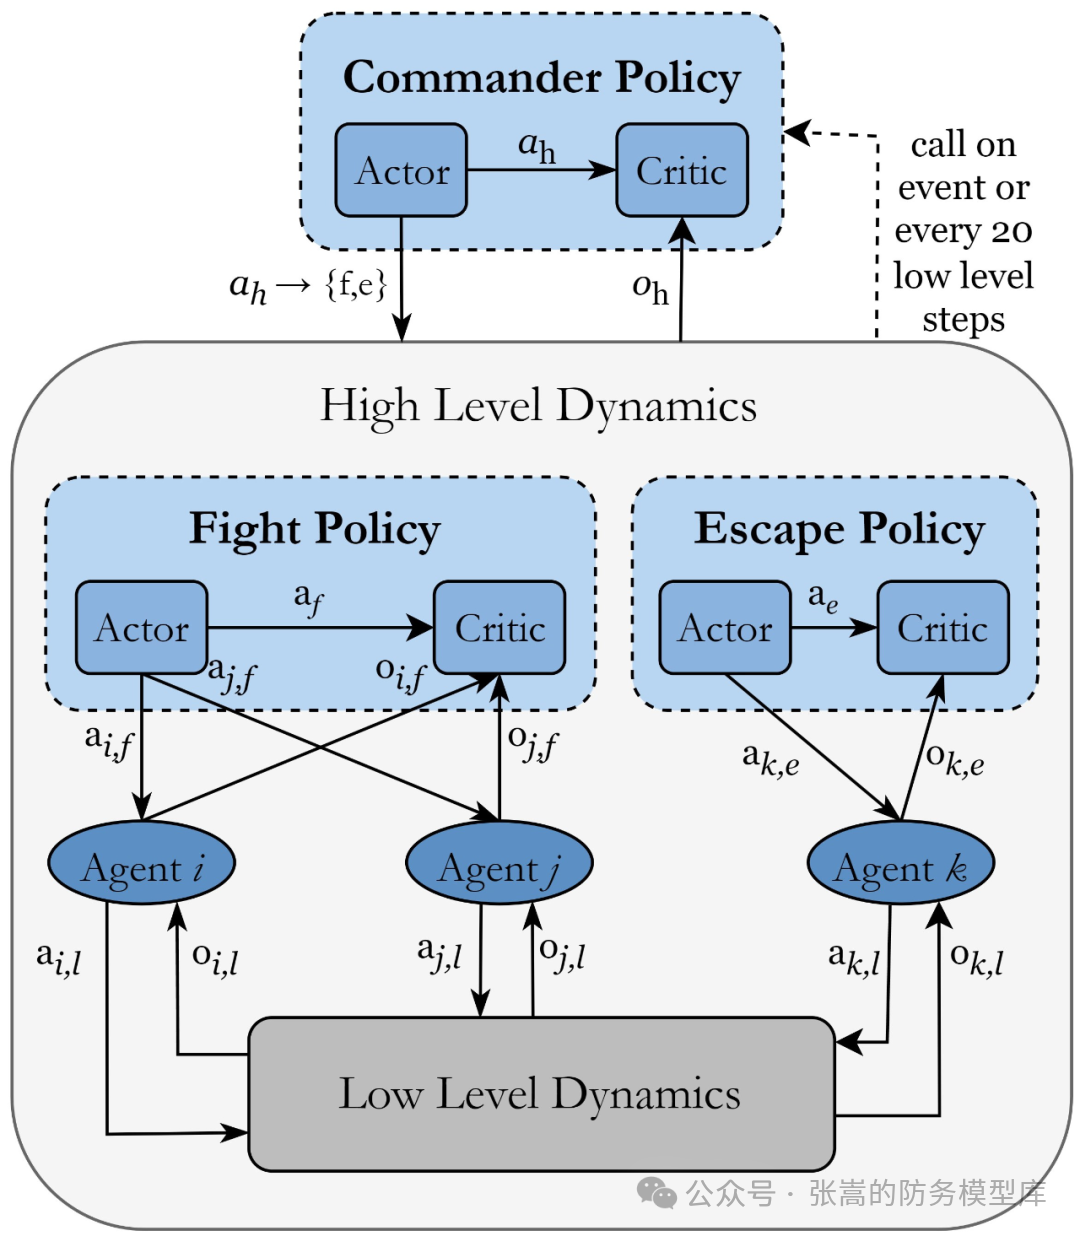
1. 高层(指挥官):做战术级决策,例如 fight/escape、选择攻击目标。奖励基于击杀、局部战术优势和逃脱成功等因素。
2. 低层(机动控制):执行航向、速度、武器发射等动作,通常遵循高层指令直到触发终止条件(如靠近敌人或达到子步上限)。
3. 多智能体协作:我方和敌方智能体共存,奖励可共享(glob_frac 控制共享比例),支持从自私到完全团队协作的训练策略。
4 仿真建模
虚拟空战环境包括:
1. 单位模型:飞机和导弹属性(位置、速度、航向、最大转角等)。