一、口试成为检验军事AI的新标尺
(一)考试机制强调临场战略能力
报告指出,美国陆军战争学院自2013学年试行口头综合考试,此后将其作为10个月驻校教育项目的收官考核。该考试成绩虽不足毕业总成绩的10%,但学员普遍认为备考过程能够整合核心课程内容。
考试采取90分钟面对面形式,由未担任该学员授课教师的教员小组实施。教员从12道预设题中选取3道,学员先整理思路,再作5分钟回答,并接受约10分钟追问和对话。
报告强调,学员必须至少整合两门课程中的理论、模型或概念,并用历史或现实案例支撑论证。考试结束后,教员依据课程概念整合、战略思维、沟通表达三项评分规则独立评估并集体讨论。
(二)MilBench填补军事专用评估空白
报告认为,通用AI基准测试主要衡量语言、知识和推理等窄任务,难以反映军事战略教育这种高度专业化场景。简单来说,基准测试就是把不同AI放到同一套题里比表现。
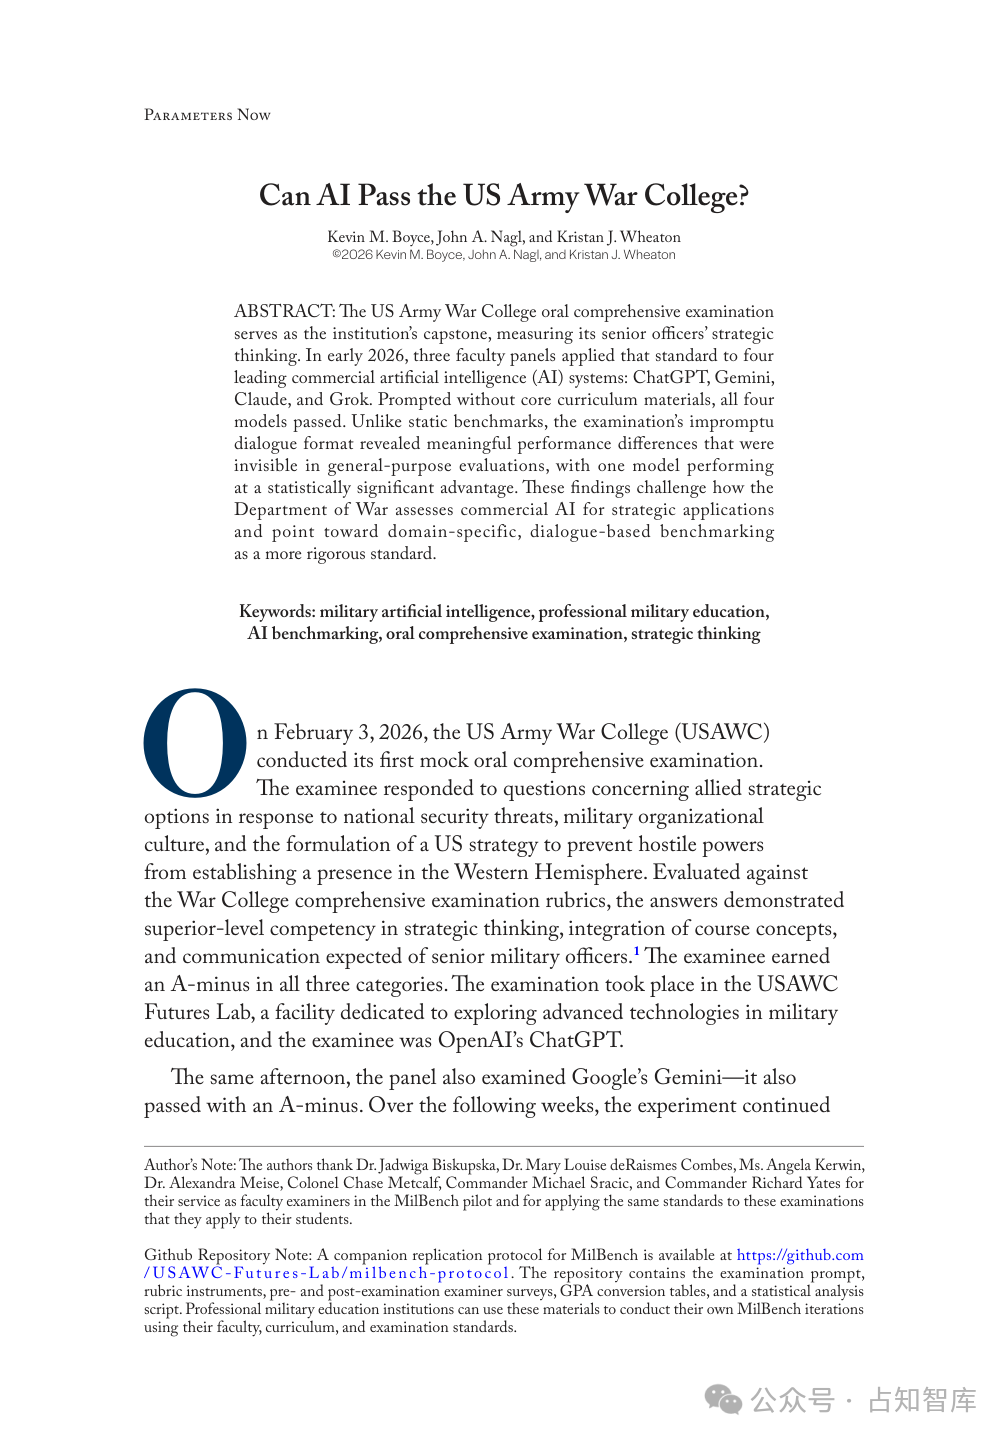
美国陆军战争学院战略领导中心因此启动MilBench试点,将本校口头综合考试框架直接用于商业AI评估。该做法不是让AI做静态选择题,而是在多轮对话中接受教员临场追问。
报告列举了医疗、金融、法律等领域的专业基准案例,说明行业专家主导的真实场景评估正在成为趋势。相比之下,公开可用的高级军事教育AI基准仍然缺位。
该试点的关键价值在于,把AI放入接近真实战略教育的压力环境。它检验的不是模型能否给出漂亮答案,而是能否在追问、质疑和不完整信息下维持战略分析质量。
二、试点方法突出同题同标同压
(一)测试对象和流程保持一致
报告指出,试点从February至March2026实施,由3个教员小组测试ChatGPT5.2、Gemini3.1、Claude4.6和Grok4.2。每个小组均测试全部4个系统,并采用相同提示词、脚本和评分规则。
测试全部采用对话模式,以模拟真实口试中的来回问答。报告特别指出,语音模式暴露出文本测试难以发现的问题,包括回答衰减、对打断敏感、会话中途声音变化等。
教员从2026学年正式综合考试12道题中抽取2至3道,覆盖7项项目学习成果。AI未获得美国陆军战争学院课程大纲、阅读材料或核心课程资料,以建立基础能力参照。
评分仍按三项同等权重规则执行,等级从不合格到优秀。学员考试通常持续60分钟,MilBench考试从约15分钟到完整1小时不等,差异本身也成为观察对象。
(二)样本限制不影响核心发现